产品文档 / Excel催化剂
网页数据采集功能再升级,完美采集公众号文章并合并pdf合集
网络时代,没有在网络上获取信息的数据分析是不完整的分析,而面对铺天盖地的python爬虫培训班,当中有多少人合适参加能收获到技能学以致用的不得而知。 在Excel催化剂的辅助下,只需一点点爬虫知识的掌握,即可零代码完成许多自己想获取的网页内容的采集工作。 因新的一年开始,又到了各大公众号总结,推出精
网络时代,没有在网络上获取信息的数据分析是不完整的分析,而面对铺天盖地的python爬虫培训班,当中有多少人合适参加能收获到技能学以致用的不得而知。
在Excel催化剂的辅助下,只需一点点爬虫知识的掌握,即可零代码完成许多自己想获取的网页内容的采集工作。
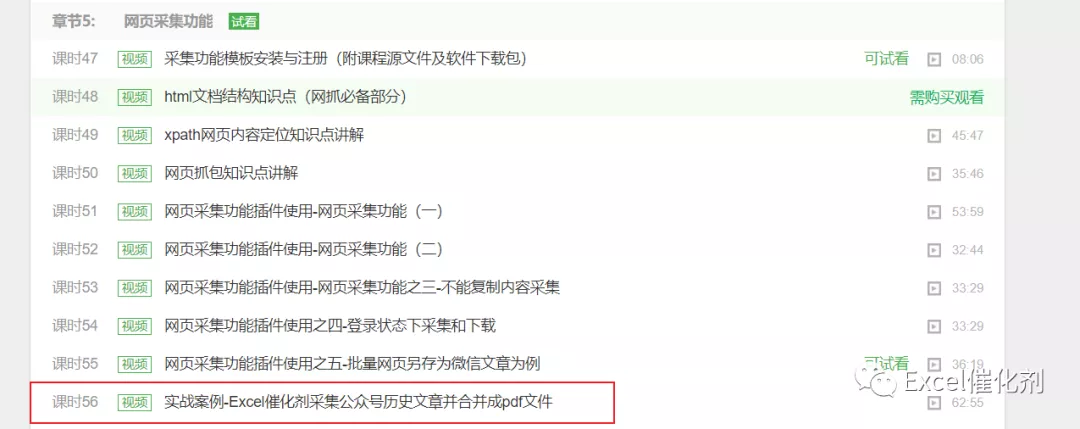
因新的一年开始,又到了各大公众号总结,推出精华内容的时候,所以Excel催化剂也再次升级,可以让大家无障碍采集到自己想公众号文章,将网页采集功能再升级,并且录制了1小时的实战视频,带大家完整地完成公众号文章采集并最终合并为pdf文章合集的技能。
更新说明20210111
- 新增了两大参数(cookie和userAgent)供在Excel模板上使用。
可满足不能常规使用网页登录来获取cookie和设备不是普通网页浏览器的情形使用,如本次的公众号文章采集实战,只能在微信PC客户端上抓包,不能使用浏览器来访问登录。
- 在Selenium的反爬特征码识别上再增强
爬虫与反爬虫并存,想爬点信息,就算模拟浏览器访问,现在很多大厂的网页都照样封杀,与时俱进再升级了一些特殊码识别的防护,让使用Selenium的模板浏览器采集能够跳过反爬的识别。
因网页采集功能无论怎么设计,对一般人都是有些难度的,所以有完整的配套视频可跟进学习,更易掌握,今天新出炉的1小时实战视频到位。在【阅读原文】上可跳转到网易云课堂购买观看。