网友作品 #000047 · 提交于 2026/08/06
PDF条码二维码文本提取器:按页按区域自动识别计数
★★★★★业余水平python
作品简介
这是一款从 PDF 中按设定页面与区域自动提取「暗码」信息的桌面工具,暗码包括条码、二维码以及印刷文本,提取结果累计输出。
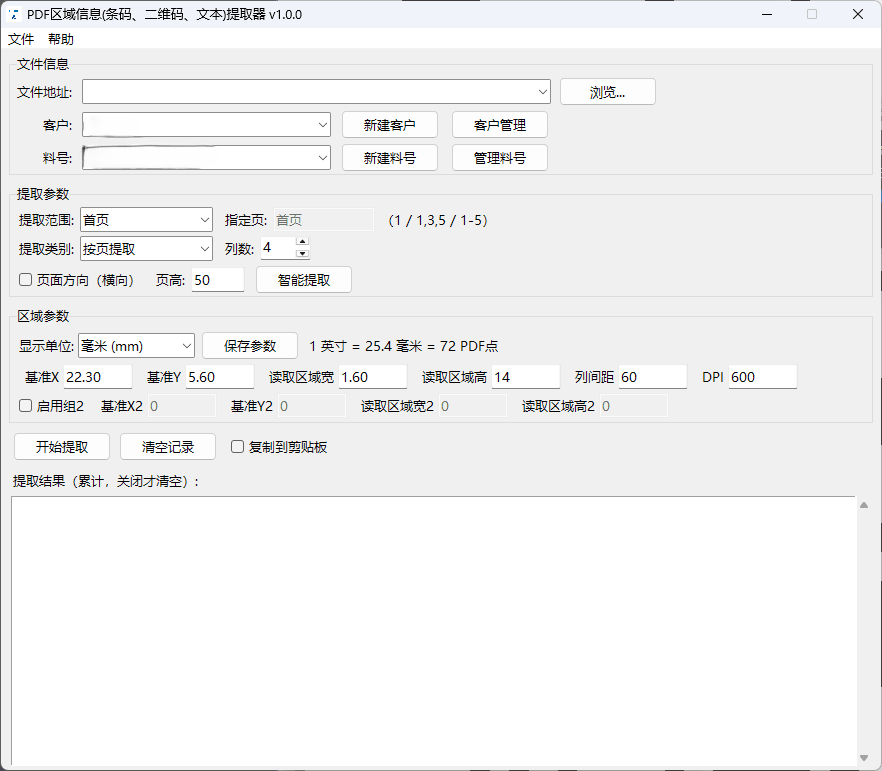
工具以客户—料号两级层级管理提取参数:每个料号绑定一套区域与提取参数,选择 PDF 后按文件名(去日期后缀)自动匹配对应料号,无需重复配置。提取时支持首页、尾页、首尾页或指定页(如 1,3,5、1-5),并可按页面方向智能扫描页头/页尾或页左/页右指定页高范围内的全部条码二维码,自动输出位置与计数。
顶部菜单提供配置一键备份/还原,关于窗口显示版本号,便于记录优化历史。
核心亮点
- 多类型自动识别:对每个区域依次尝试文本、条码、二维码,无需手动选择识别方式
- 灵活提取范围:首页 / 尾页 / 首尾页 / 指定页,多页码与区间写法均支持
- 智能提取:按页面方向自动扫描页头/页尾(横向)或页左/页右(纵向)指定页高范围,无需逐列设置区域参数,输出位置与计数
- 区域参数精调:基准 X/Y、读取区域宽高、列间距、DPI 逐项可调,支持毫米/英寸单位换算,可启用第二组区域
- 料号参数化:客户—料号层级绑定参数集,切换料号即载入对应配置
- 文件名智能匹配:按文件名(去日期后缀)自动匹配料号
- 累计输出:结果累计显示、支持复制到剪贴板,关闭窗口才清空
- 配置可备份:一键备份/还原全部配置,版本号可追溯
技术与工具
- 使用 Python 完成整个工具开发,界面涵盖文件信息、提取参数、区域参数、结果输出四大区域
- 区域坐标支持毫米与 PDF 点换算(1 英寸 = 25.4 毫米 = 72 PDF 点),可按 DPI 精度读取
- 由作者以业余水平借助 AI 调整完成,开发门槛低、适配细分需求
适用场景
- 制造业物料管理:提取物料工单、入库单 PDF 上的条码与料号信息,快速完成单据录入与核验
- 文档归档管理:批量提取存档 PDF 的页眉页脚编号、二维码标识,用于文档分类与台账统计
原始提交内容(点开查看,可复制全文去问 AI)
从 PDF 中按设定的页面与区域,自动提取条码、二维码以及印刷文本(统称“暗码”)信息,并累计输出。
自动识别:对每个区域依次尝试 文本 条码 二维码,无需手动选识别方式。 按页提取:首页 / 尾页 / 首尾页 / 指定页(下拉项已更名为「提取范围」,不再带“暗码内容”字样)。 智能提取:按「提取范围」决定的页码,自动扫描页头/页尾(横向)或页左/页右(纵向)指定页高范围内全部条码、二维码,无需逐列设置区域参数,并输出位置与计数。 料号参数化:每个料号绑定一套区域 + 提取参数,切换料号即载入。 客户 / 料号层级:一个客户可含多个料号。 文件名智能匹配:选 PDF 后按文件名(去日期后缀)自动匹配料号。 版本与备份:顶部菜单「文件」支持一键备份/还原配置;关于窗口显示版本号,便于记录优化历史。