网友作品 #000011 · 提交于 2026/08/04
可转债量化分析工具:三大策略筛选与回测
作品简介
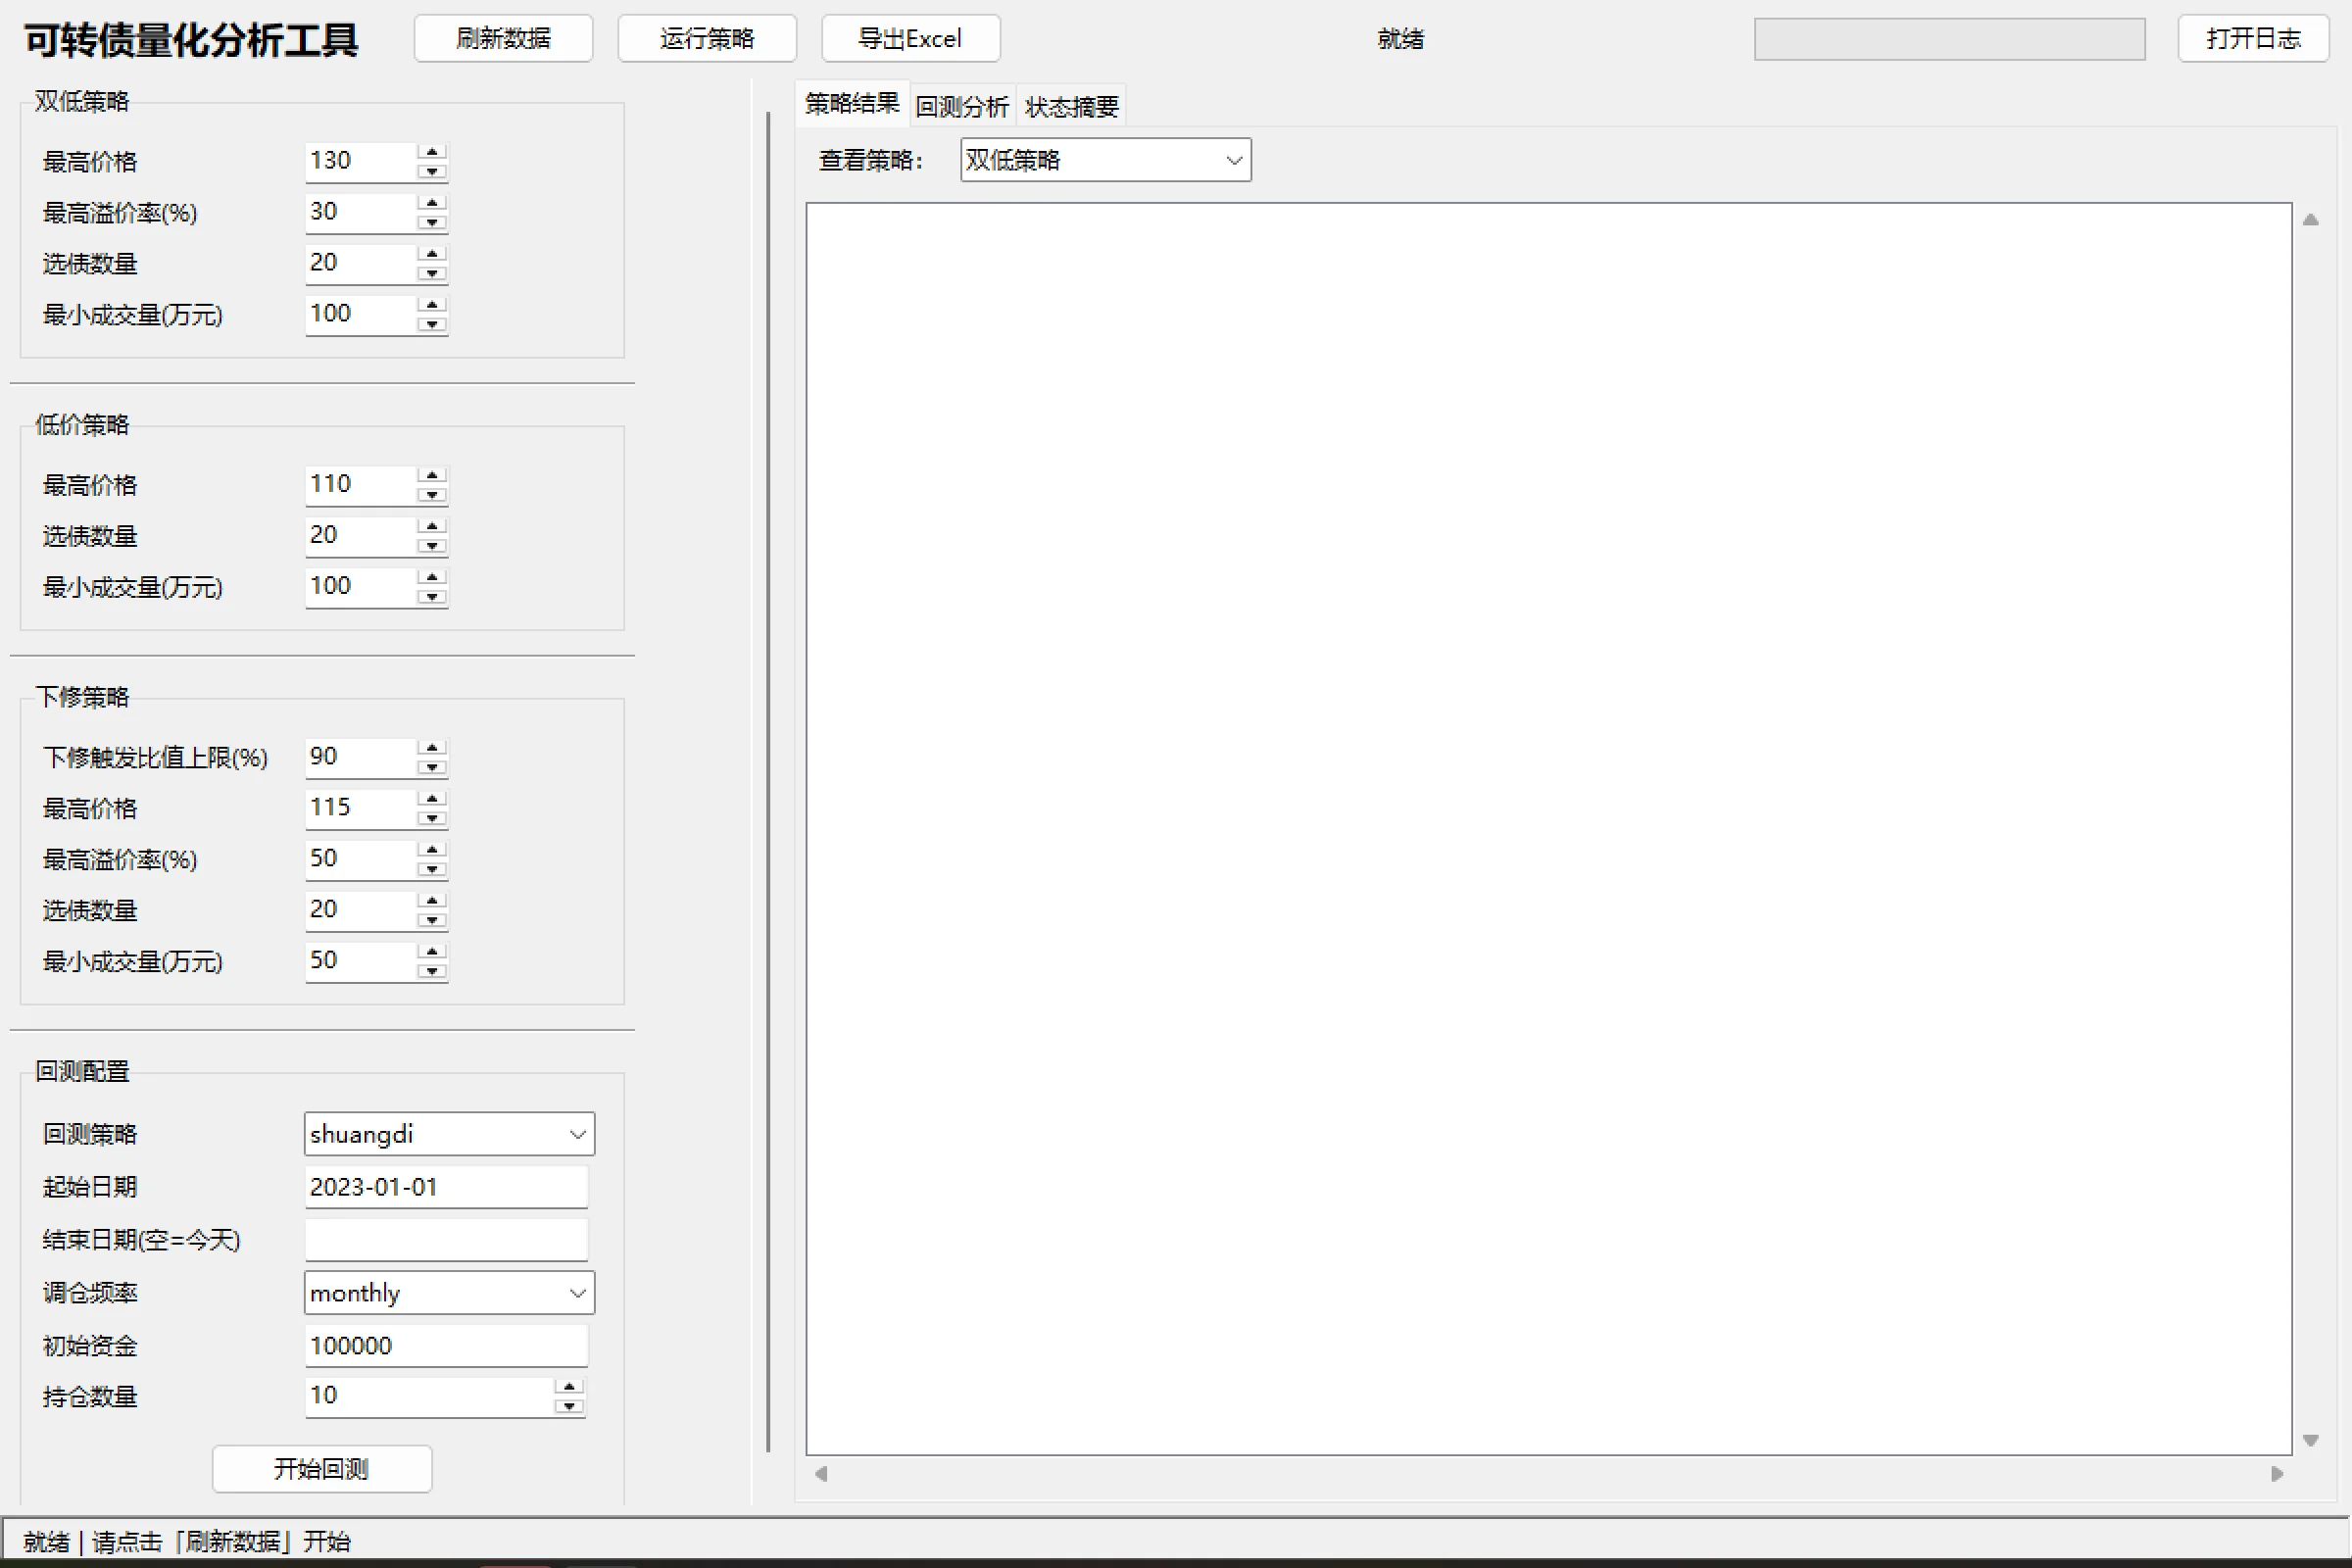
「可转债量化分析工具」(cb_quant)是基于 Python 3.12 + tkinter 的 GUI 量化程序,已打包为可执行文件。界面左侧是双低、低价、下修三组策略参数与回测配置,右侧提供策略结果、回测分析、状态摘要三个页签;顶部一键完成刷新数据、运行策略、导出 Excel、打开日志,底部状态栏给出操作提示。
核心亮点
- 三大内置策略:双低策略(价格+溢价率从小到大取前 N 只)、低价策略(价格升序)、下修策略(以股价/转股价比值博弈下修条款触发)
- 策略参数全可调:最高价格、溢价率上限、选债数量、最小成交量、是否排除已强赎、下修触发比值上限等,界面直接改
- 多源数据容错:优先 akshare 集思录接口,失败自动降级到东方财富全量接口,请求带重试机制,可抓取全市场 300+ 只转债行情与条款数据
- 衍生指标自动计算:转股溢价率、下修触发比值等自动补齐
- 回测引擎:自定义起止日期、调仓频率(每周/每月)、初始资金、持仓数量与手续费率,模拟定期再平衡
- 绩效输出:权益曲线、交易记录,以及总收益、年化收益、最大回撤、夏普比率等指标
- 结果可导出:一键导出 Excel,配合日志系统便于复查
技术与工具
- 技术栈:Python 3.12 + tkinter GUI
- 数据:akshare(集思录接口)、requests(东方财富备用源,带重试)
- 计算与绘图:pandas、numpy,matplotlib / pyecharts
- 工程:hatchling 构建、pytest 测试目录、PyInstaller 打包 exe
开发过程
项目按模块拆分:data_fetcher 负责多源数据抓取与指标计算,strategies 实现三大策略引擎,backtest 负责再平衡回测与绩效统计,另有日志配置与 GUI 层,配套 pyproject 依赖管理与测试目录,最后由 PyInstaller 打包成可执行文件。作者自述第一次做出完整软件,耗时不大、成就感满满。
适用场景
- 个人可转债投资者:日常筛选标的、验证策略历史表现,辅助投资决策
- 量化入门学习者:参考其数据抓取、策略引擎、回测引擎的完整项目结构进行学习
原始提交内容(点开查看,可复制全文去问 AI)
可转债量化工具 — 源代码文档 项目:可转债量化分析工具 功能:双低策略 / 低价策略 / 下修策略 / 回测分析 技术栈:Python 3.12 + tkinter + akshare + pandas + matplotlib
项目结构 cb_quant/ run.py # PyInstaller 打包入口 pyproject.toml # 项目配置与依赖 src/ cb_quant/ init.py main.py # 程序入口 core.py # 核心业务逻辑 data_fetcher.py # 数据抓取模块 strategies.py # 策略引擎模块 backtest.py # 回测引擎模块 logging_setup.py # 日志系统配置 ui/ app.py # GUI 主界面 dist/ 可转债量化工具/ 可转债量化工具.exe # 打包产物 tests/
- pyproject.toml — 项目配置 [project] name = “cb-quant” version = “0.1.0” description = “可转债量化分析工具,支持双低策略、低价策略、下修策略,实时数据抓取与回测分析” readme = “README.md” requires-python = “>=3.12” dependencies = [ “akshare>=1.18.81”, “beautifulsoup4>=4.15.0”, “lxml>=6.1.1”, “matplotlib>=3.11.1”, “pandas>=3.0.5”, “pyecharts>=2.1.0”, “python-dotenv>=1.0.1”, “requests>=2.34.2”, ]
[build-system] requires = [“hatchling”] build-backend = “hatchling.build”
[project.scripts] cb-quant = “cb_quant.main:main”
[tool.ruff] line-length = 100 target-version = “py312”
[tool.ruff.lint] select = [“E”, “F”, “I”, “N”, “UP”]
[tool.pytest.ini_options] testpaths = [“tests”]
[tool.mypy] python_version = “3.12” ignore_missing_imports = true warn_return_any = true
[dependency-groups] dev = [ “pyinstaller>=6.21.0”, ] 2. run.py — 打包入口脚本 “”“可转债量化工具 入口脚本。
供 PyInstaller 打包使用。 “””
from cb_quant.main import main
if name == “main”: main() 3. main.py — 程序主入口 from future import annotations
import logging
from cb_quant.logging_setup import configure_logging from cb_quant.ui.app import launch_app
LOGGER = logging.getLogger(name)
def main() -> None: log_file = configure_logging() LOGGER.info(“GUI 程序启动,日志文件:%s”, log_file) launch_app()
if name == “main”: main() 4. data_fetcher.py — 数据抓取模块 “”“可转债数据实时抓取模块。
数据源优先级: 1. akshare 集思录接口(bond_cb_jsl) 2. 东方财富 push2 全量接口(备用) “””
from future import annotations
import logging import time from typing import Any
import pandas as pd import requests from requests.adapters import HTTPAdapter from urllib3.util.retry import Retry
LOGGER = logging.getLogger(name)
_USER_AGENT = ( “Mozilla/5.0 (Windows NT 10.0; Win64; x64) “ “AppleWebKit/537.36 (KHTML, like Gecko) “ “Chrome/125.0.0.0 Safari/537.36” )
def _create_em_session() -> requests.Session: “”“创建带重试机制的东方财富请求会话。”“” session = requests.Session() retry = Retry(total=2, backoff_factor=1, status_forcelist=[429, 500, 502, 503]) adapter = HTTPAdapter(max_retries=retry) session.mount(“https://”, adapter) session.mount(“http://”, adapter) session.headers.update({“User-Agent”: _USER_AGENT}) return session
============================================================
akshare 集思录接口(主数据源,优先)
============================================================
def fetch_cb_spot_jisilu() -> pd.DataFrame: “”“通过 akshare 获取集思录可转债数据。
返回的 DataFrame 包含完整的可转债行情与条款数据,
已自动标准化列名。
"""
import akshare as ak

try:
    df = ak.bond_cb_jsl(cookie="")

    if df is None or df.empty:
        LOGGER.warning("akshare 集思录数据为空")
        return pd.DataFrame()

    # 标准化列名
    col_map = {
        "代码": "bond_id", "转债名称": "bond_nm", "现价": "price",
        "转股价值": "convert_value", "转股价": "convert_price",
        "转股溢价率": "premium_rt", "正股价": "stock_price",
        "正股名称": "stock_name", "正股代码": "stock_code",
        "债券评级": "rating_cd", "到期税前收益": "maturity_ytm",
        "成交额": "volume", "剩余规模": "amount",
        "剩余年限": "year_left", "上市时间": "list_date",
        "回售触发价": "put_convert_price_ratio",
        "强赎触发价": "force_redeem_price",
        "双低": "shuangdi_value", "涨跌幅": "change_pct",
        "正股PB": "pb", "到期时间": "maturity_date",
        "换手率": "turnover_rate", "正股涨跌": "stock_change_pct",
        "转债占比": "cb_ratio",
    }
    for old, new in col_map.items():
        if old in df.columns:
            df.rename(columns={old: new}, inplace=True)

    LOGGER.info("集思录可转债数据获取成功,共 %d 条", len(df))
    return df

except Exception:
    LOGGER.exception("akshare 集思录数据获取失败")
    return pd.DataFrame()
============================================================
东方财富 push2 全量接口(备用,数据量更大)
============================================================
_EM_FIELDS_MAP = { “f2”: “price”, “f3”: “change_pct”, “f12”: “bond_id”, “f14”: “bond_nm”, “f15”: “high”, “f16”: “low”, “f17”: “open”, “f18”: “pre_close”, “f20”: “volume”, “f21”: “amount”, “f26”: “list_date”, “f229”: “convert_price”, “f230”: “maturity_ytm”, “f232”: “stock_code”, “f234”: “stock_name”, “f235”: “stock_price”, “f236”: “convert_value”, }
def _fetch_em_page(session: requests.Session, page: int, page_size: int = 200) -> pd.DataFrame: “”“获取东方财富单页数据。”“” url = “https://push2.eastmoney.com/api/qt/clist/get” fields = “,”.join(_EM_FIELDS_MAP.keys()) params: dict[str, Any] = { “pn”: str(page), “pz”: str(page_size), “po”: “1”, “np”: “1”, “ut”: “bd1d9ddb04089700cf9c27f6f7426281”, “fltt”: “2”, “invt”: “2”, “fid”: “f3”, “fs”: “b:MK0354”, “fields”: fields, }
try:
    resp = session.get(url, params=params, timeout=20)
    resp.raise_for_status()
    data = resp.json()

    if data.get("data") is None:
        return pd.DataFrame()

    items = data["data"].get("diff", [])
    if not items:
        return pd.DataFrame()

    rows = []
    for item in items:
        row = {col_name: item.get(field_key, None) for field_key, col_name in _EM_FIELDS_MAP.items()}
        rows.append(row)

    return pd.DataFrame(rows)

except Exception:
    LOGGER.exception("东方财富第 %d 页获取失败", page)
    return pd.DataFrame()
def fetch_cb_spot_eastmoney() -> pd.DataFrame: “”“从东方财富获取全量可转债数据(319+条)。”“” LOGGER.info(“尝试东方财富全量接口…”) session = _create_em_session()
# 先探测总数
try:
    url = "https://push2.eastmoney.com/api/qt/clist/get"
    params: dict[str, Any] = {
        "pn": "1", "pz": "1", "po": "1", "np": "1",
        "ut": "bd1d9ddb04089700cf9c27f6f7426281",
        "fltt": "2", "invt": "2", "fid": "f3",
        "fs": "b:MK0354", "fields": "f12",
    }
    resp = session.get(url, params=params, timeout=20)
    total = resp.json().get("data", {}).get("total", 0)
    LOGGER.info("东方财富可转债总数:%d", total)
except Exception:
    LOGGER.warning("无法获取东方财富总数,仅获取首页")
    total = 200

all_frames = []
page_size = 200
total_pages = max((total + page_size - 1) // page_size, 1)

for page in range(1, total_pages + 1):
    if page > 1:
        time.sleep(0.5)
    page_df = _fetch_em_page(session, page, page_size)
    if not page_df.empty:
        all_frames.append(page_df)

if not all_frames:
    LOGGER.warning("东方财富所有页均为空")
    return pd.DataFrame()

result = pd.concat(all_frames, ignore_index=True)

# 计算溢价率
if "price" in result.columns and "convert_value" in result.columns:
    result["premium_rt"] = result.apply(
        lambda row: round((row["price"] / row["convert_value"] - 1) * 100, 2)
        if (pd.notna(row.get("price")) and pd.notna(row.get("convert_value"))
            and row.get("convert_value", 0) > 0)
        else None,
        axis=1,
    )

LOGGER.info("东方财富数据获取完成,共 %d 条", len(result))
return result
============================================================
下修指标计算
============================================================
def compute_xiuxiu_indicators(df: pd.DataFrame) -> pd.DataFrame: “”“计算下修相关指标。
下修触发比值 = 正股价 / 转股价 × 100
"""
if df.empty:
    return df

df = df.copy()

for col in ["stock_price", "convert_price"]:
    if col in df.columns:
        df[col] = pd.to_numeric(df[col], errors="coerce")

if "stock_price" in df.columns and "convert_price" in df.columns:
    df["xiuxiu_trigger_ratio"] = df.apply(
        lambda row: round(row["stock_price"] / row["convert_price"] * 100, 2)
        if (pd.notna(row.get("stock_price"))
            and pd.notna(row.get("convert_price"))
            and row.get("convert_price", 0) > 0)
        else None,
        axis=1,
    )

return df
============================================================
历史数据(用于回测)
============================================================
def fetch_cb_daily_history(bond_id: str, start_date: str = “”, end_date: str = “”) -> pd.DataFrame: “”“获取单只可转债的历史日线数据。”“” import akshare as ak
try:
    code = bond_id
    if not code.startswith("sh") and not code.startswith("sz"):
        code = f"sh{code}" if code.startswith("11") else f"sz{code}"

    df = ak.bond_cb_daily(symbol=code)

    if df is None or df.empty:
        LOGGER.warning("可转债 %s 历史数据为空", bond_id)
        return pd.DataFrame()

    col_map = {
        "date": "date", "open": "open", "high": "high",
        "low": "low", "close": "close", "volume": "volume",
    }
    for k, v in col_map.items():
        if k in df.columns and k != v:
            df.rename(columns={k: v}, inplace=True)

    if start_date and "date" in df.columns:
        df = df[df["date"] >= start_date]
    if end_date and "date" in df.columns:
        df = df[df["date"] <= end_date]

    LOGGER.info("可转债 %s 历史数据成功,共 %d 条", bond_id, len(df))
    return df

except Exception:
    LOGGER.exception("可转债 %s 历史数据获取失败", bond_id)
    return pd.DataFrame()
def fetch_cb_history_batch( bond_ids: list[str], start_date: str = “”, end_date: str = “” ) -> dict[str, pd.DataFrame]: “”“批量获取多只可转债历史数据。”“” result: dict[str, pd.DataFrame] = {} for bid in bond_ids: df = fetch_cb_daily_history(bid, start_date, end_date) if not df.empty: result[bid] = df return result
============================================================
一键获取
============================================================
def fetch_all_cb_data() -> pd.DataFrame: “”“一键获取全部可转债实时数据。
优先 akshare 集思录,失败后降级到东方财富。
"""
LOGGER.info("开始获取可转债实时数据...")

# 方案1:akshare 集思录(稳定,数据字段全)
df = fetch_cb_spot_jisilu()
if not df.empty:
    LOGGER.info("使用集思录数据,共 %d 条", len(df))
    return df

# 方案2:东方财富全量接口
LOGGER.warning("集思录获取失败,尝试东方财富...")
df = fetch_cb_spot_eastmoney()
if not df.empty:
    LOGGER.info("使用东方财富数据,共 %d 条", len(df))
    return df

LOGGER.error("所有数据源均获取失败")
return pd.DataFrame()
5. strategies.py — 策略引擎模块 “”“量化策略引擎模块。
实现三大策略: 1. 双低策略(低价格 + 低溢价率) 2. 低价策略(只看价格) 3. 下修策略(博弈下修条款触发) “””
from future import annotations
import logging from dataclasses import dataclass, field
import pandas as pd
LOGGER = logging.getLogger(name)
============================================================
数据结构
============================================================
@dataclass class StrategyResult: “”“策略筛选结果。”“”
strategy_name: str
bonds: pd.DataFrame
score_col: str = ""
description: str = ""
============================================================
策略参数
============================================================
@dataclass class ShuangdiParams: “”“双低策略参数。
双低值 = 价格 + 溢价率
"""

max_price: float = 130.0  # 最高价格
max_premium_rt: float = 30.0  # 最高溢价率(%)
top_n: int = 20  # 选前 N 只
min_volume: float = 100.0  # 最小成交量(万元),过滤无流动性标的
exclude_force_redeem: bool = True  # 排除已触发强赎的
@dataclass class DijiaParams: “”“低价策略参数。”“”
max_price: float = 110.0  # 最高价格
top_n: int = 20  # 选前 N 只
min_volume: float = 100.0  # 最小成交量(万元)
min_maturity_ytm: float = -5.0  # 最低到期收益率(%),排除极端负收益
@dataclass class XiuxiuParams: “”“下修策略参数。
核心逻辑:
- 寻找正股价格接近或低于下修触发价的转债
- 下修触发条件通常为:连续N个交易日中至少M个交易日正股价低于转股价×K%
- 这里用 正股价/转股价 比值作为下修可能性的代理指标
"""

max_trigger_ratio: float = 90.0  # 股价/转股价 最大比值(%),越小越可能触发下修
max_price: float = 115.0  # 最高转债价格
max_premium_rt: float = 50.0  # 最高溢价率(%)
top_n: int = 20  # 选前 N 只
min_volume: float = 50.0  # 最小成交量(万元)
============================================================
策略实现
============================================================
def _filter_valid_bonds(df: pd.DataFrame, min_volume: float) -> pd.DataFrame: “”“基础过滤:去除无效数据、停牌、无成交量的标的。”“” if df.empty: return df
df = df.copy()

# 过滤价格为0或空的行
if "price" in df.columns:
    df = df[df["price"] > 0]

# 过滤成交量为0的(可能停牌)
if "volume" in df.columns and min_volume > 0:
    df = df[df["volume"] >= min_volume]

return df
def run_shuangdi_strategy(df: pd.DataFrame, params: ShuangdiParams | None = None) -> StrategyResult: “”“执行双低策略。
双低值 = 价格 + 溢价率
按双低值从小到大排序,取前 N 只。
"""
if params is None:
    params = ShuangdiParams()

LOGGER.info("执行双低策略:max_price=%s, max_premium=%s, top_n=%s",
            params.max_price, params.max_premium_rt, params.top_n)

if df.empty:
    return StrategyResult(strategy_name="双低策略", bonds=pd.DataFrame(),
                          score_col="双低值", description="数据为空,无法执行策略")

df = _filter_valid_bonds(df, params.min_volume)

# 筛选条件
mask = pd.Series(True, index=df.index)

if "price" in df.columns:
    mask &= df["price"] <= params.max_price

if "premium_rt" in df.columns:
    mask &= df["premium_rt"] <= params.max_premium_rt

# 排除强赎
if params.exclude_force_redeem and "force_redeem_price" in df.columns:
    mask &= df["force_redeem_price"].fillna(0) == 0

filtered = df[mask].copy()

# 计算双低值
filtered["双低值"] = filtered["price"].fillna(0) + filtered["premium_rt"].fillna(0).abs()

# 按双低值排序
filtered = filtered.sort_values("双低值", ascending=True).head(params.top_n)

return StrategyResult(
    strategy_name="双低策略",
    bonds=filtered,
    score_col="双低值",
    description=f"双低策略:价格{params.max_price},溢价率{params.max_premium_rt}%,"
                 f"按双低值(价格+溢价率)排序,选前{params.top_n}只",
)
def run_dijia_strategy(df: pd.DataFrame, params: DijiaParams | None = None) -> StrategyResult: “”“执行低价策略。
纯粹按价格从低到高排序,选前 N 只。
"""
if params is None:
    params = DijiaParams()

LOGGER.info("执行低价策略:max_price=%s, top_n=%s", params.max_price, params.top_n)

if df.empty:
    return StrategyResult(strategy_name="低价策略", bonds=pd.DataFrame(),
                          score_col="价格", description="数据为空,无法执行策略")

df = _filter_valid_bonds(df, params.min_volume)

mask = pd.Series(True, index=df.index)

if "price" in df.columns:
    mask &= df["price"] <= params.max_price

if "maturity_ytm" in df.columns and params.min_maturity_ytm is not None:
    mask &= df["maturity_ytm"] >= params.min_maturity_ytm

filtered = df[mask].copy()

# 按价格升序
filtered = filtered.sort_values("price", ascending=True).head(params.top_n)

return StrategyResult(
    strategy_name="低价策略",
    bonds=filtered,
    score_col="price",
    description=f"低价策略:价格{params.max_price},按价格升序,选前{params.top_n}只",
)
def run_xiuxiu_strategy( df: pd.DataFrame, xiuxiu_df: pd.DataFrame | None = None, params: XiuxiuParams | None = None ) -> StrategyResult: “”“执行下修策略。
筛选逻辑:
1. 股价/转股价 比值越低,下修可能性越大
2. 转债价格不能太高(否则下修收益有限)
3. 溢价率不能太高
"""
if params is None:
    params = XiuxiuParams()

LOGGER.info("执行下修策略:max_trigger_ratio=%s%%, max_price=%s, top_n=%s",
            params.max_trigger_ratio, params.max_price, params.top_n)

# 优先使用下修专用数据
if xiuxiu_df is not None and not xiuxiu_df.empty:
    work_df = xiuxiu_df.copy()
elif not df.empty:
    work_df = df.copy()
else:
    return StrategyResult(strategy_name="下修策略", bonds=pd.DataFrame(),
                          score_col="下修触发比值(%)", description="数据为空,无法执行策略")

work_df = _filter_valid_bonds(work_df, params.min_volume)

mask = pd.Series(True, index=work_df.index)

if "price" in work_df.columns:
    mask &= work_df["price"] <= params.max_price

if "premium_rt" in work_df.columns:
    mask &= work_df["premium_rt"] <= params.max_premium_rt

# 下修触发比值过滤
if "xiuxiu_trigger_ratio" in work_df.columns:
    mask &= work_df["xiuxiu_trigger_ratio"] <= params.max_trigger_ratio
    mask &= work_df["xiuxiu_trigger_ratio"] > 0  # 排除无效数据

filtered = work_df[mask].copy()

# 按下修触发比值升序(越小越可能触发下修)
if "xiuxiu_trigger_ratio" in filtered.columns:
    filtered["下修评分"] = 100 - filtered["xiuxiu_trigger_ratio"]
    filtered = filtered.sort_values("xiuxiu_trigger_ratio", ascending=True)
else:
    filtered = filtered.sort_values("price", ascending=True)

filtered = filtered.head(params.top_n)

score_col = "xiuxiu_trigger_ratio" if "xiuxiu_trigger_ratio" in filtered.columns else "price"

return StrategyResult(
    strategy_name="下修策略",
    bonds=filtered,
    score_col=score_col,
    description=f"下修策略:股价/转股价{params.max_trigger_ratio}%,"
                 f"转债价格{params.max_price},溢价率{params.max_premium_rt}%,"
                 f"按下修触发比值升序,选前{params.top_n}只",
)
============================================================
一键运行所有策略
============================================================
def run_all_strategies( df: pd.DataFrame, xiuxiu_df: pd.DataFrame | None = None, shuangdi_params: ShuangdiParams | None = None, dijia_params: DijiaParams | None = None, xiuxiu_params: XiuxiuParams | None = None, ) -> list[StrategyResult]: “”“一键运行三大策略,返回结果列表。”“” results: list[StrategyResult] = []
results.append(run_shuangdi_strategy(df, shuangdi_params))
results.append(run_dijia_strategy(df, dijia_params))
results.append(run_xiuxiu_strategy(df, xiuxiu_df, xiuxiu_params))

return results
6. backtest.py — 回测引擎模块 “”“回测引擎模块。
支持:
- 定期再平衡回测(如每周、每月调仓)
- 收益曲线计算
- 绩效指标统计(年化收益、最大回撤、夏普比率、胜率等) “””
from future import annotations
import logging from dataclasses import dataclass, field from datetime import datetime, timedelta
import numpy as np import pandas as pd
from cb_quant.data_fetcher import fetch_cb_daily_history from cb_quant.strategies import ( DijiaParams, ShuangdiParams, XiuxiuParams, run_dijia_strategy, run_shuangdi_strategy, run_xiuxiu_strategy, )
LOGGER = logging.getLogger(name)
============================================================
回测配置
============================================================
@dataclass class BacktestConfig: “”“回测配置。”“”
start_date: str = "2023-01-01"  # 回测起始日期
end_date: str = ""  # 回测结束日期,空表示今天
rebalance_freq: str = "monthly"  # 调仓频率:weekly, monthly
initial_capital: float = 100000.0  # 初始资金
commission_rate: float = 0.0003  # 手续费率(万分之三)
top_n: int = 10  # 持仓数量
strategy: str = "shuangdi"  # 策略类型:shuangdi, dijia, xiuxiu
@dataclass class BacktestResult: “”“回测结果。”“”
config: BacktestConfig
daily_returns: pd.DataFrame  # 每日收益率
trades: pd.DataFrame  # 交易记录
metrics: dict  # 绩效指标
equity_curve: pd.Series  # 权益曲线

@property
def total_return(self) -> float:
    return self.metrics.get("total_return", 0.0)

@property
def annual_return(self) -> float:
    return self.metrics.get("annual_return", 0.0)

@property
def max_drawdown(self) -> float:
    return self.metrics.get("max_drawdown", 0.0)

@property
def sharpe_ratio(self) -> float:
    return self.metrics.get("sharpe_ratio", 0.0)