文章 / 公众号历史文章
懂Excel就能轻松入门Python数据分析包pandas(五):重复值处理
经常听别人说 Python 在数据领域有多厉害,结果学了很长时间,连数据处理都麻烦得要死。后来才发现,原来不是 Python 数据处理厉害,而是他有数据分析神器—— pandas 前言 有时候数据中出现重复值,可能会导致最后的统计结果出现错误,因此,查找和移除重复值是数据处理中的常见操作。今天我们来
经常听别人说 Python 在数据领域有多厉害,结果学了很长时间,连数据处理都麻烦得要死。后来才发现,原来不是 Python 数据处理厉害,而是他有数据分析神器—— pandas
前言
有时候数据中出现重复值,可能会导致最后的统计结果出现错误,因此,查找和移除重复值是数据处理中的常见操作。今天我们来看看 pandas 中是如何实现。
Excel 处理重复值
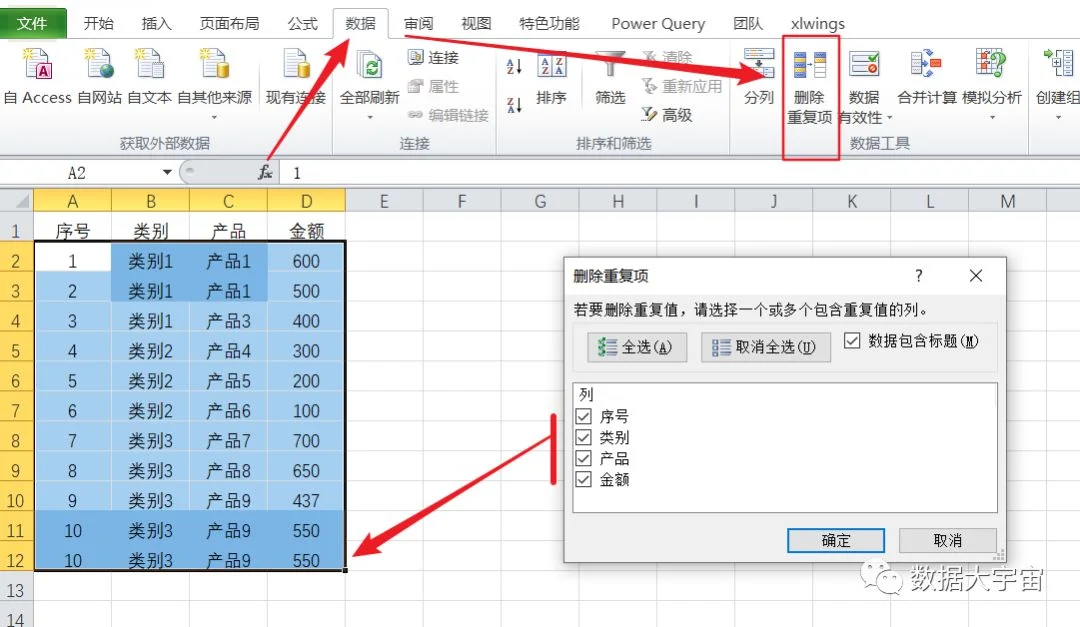
Excel 中直接提供了去除重复的功能,因此简单操作即可实现。如下:
-
- 功能卡“数据”,“数据工具”中有“删除重复项”按钮
-
- 接着可以选择以哪些列作为重复判断
除此之外,Excel 中还可以使用条件格式、高级筛选或函数公式实现差不多的功能
pandas 标记重复值
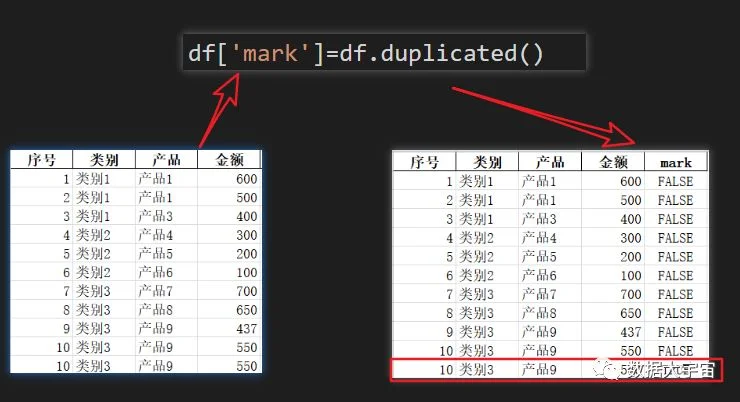
pandas 中同样提供一个简单方法标记出重复值,并且比 Excel 有更多灵活处理方式供你选择,我们来看看:
-
- DataFrame.duplicated() ,生成是否为重复记录的布尔标记。
默认是整行所有数据作为判断依据
-
- 结果很明显,最后一行是重复行,因此标记列最后一行的值是 True
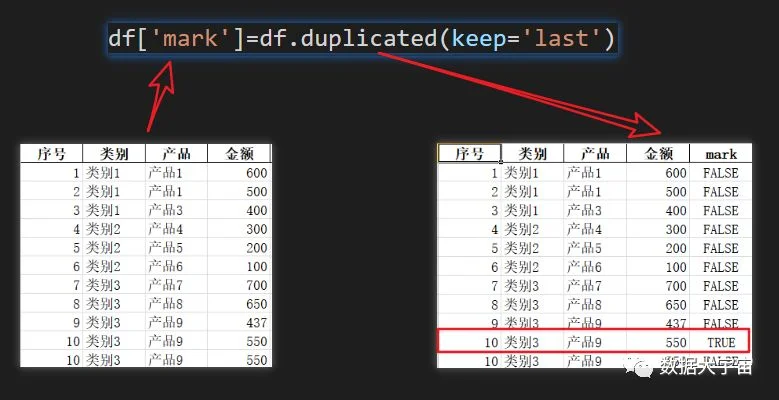
我们可以指定,当有重复值时,保留哪个位置的行。如下:
-
- 默认情况下,duplicated() 的 keep 参数为 “first”,意思为“保留第一个”
-
- 现在我们把 keep 设置为“last”,那么保留最后一个,因此现在重复的行中的第一行被标记为 True
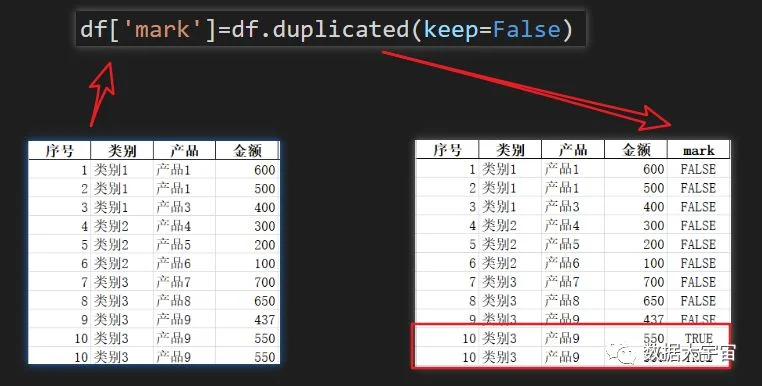
除此之外,我们还可以把 keep 参数设置为 False,意思是“不保留”,如下:
-
- 现在凡是存在重复的行,都被标记 True
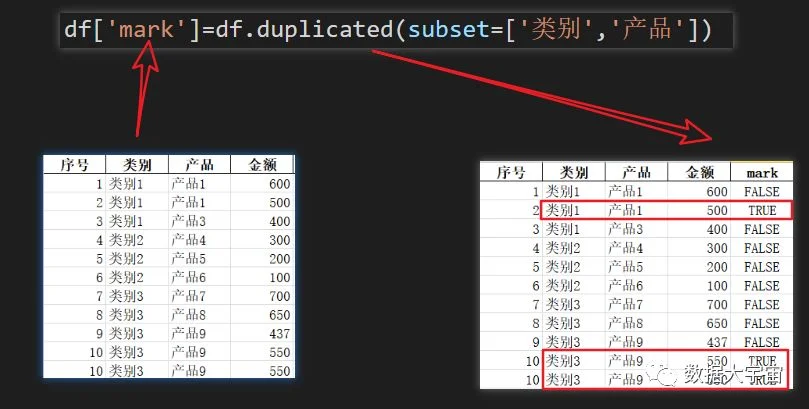
通过参数 subset 可以指定哪些列作为判断依据:
像 Excel 一样去除重复
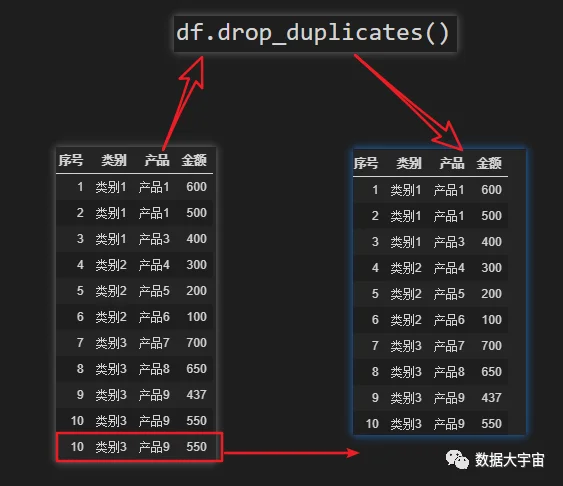
其实把重复值标记后,只需要简单筛选即可得到非重复的记录。但是 pandas 中有直接的方法去除重复。如下:
-
- 调用 DataFrame.drop_duplicates() ,即可去除重复
-
- 他的参数与规则与 duplicated 一模一样。
实际就是把 duplicated() 标记为 True 的行去掉而已
最后
-
- DataFrame.duplicated() ,标记出重复项。
使用 subset 指定重复值判断列,keep={‘first’,‘last’,False} 指定怎么判断哪些是重复项
-
- DataFrame.drop_duplicates() ,去除重复项
下一节,将看看排序功能的实现。敬请关注。
**如果希望从零开始学习 pandas ,那么可以看看我的 pandas 专栏。**
扫描二维码
获取更多精彩
数据大宇宙