文章 / 公众号历史文章
懂Excel轻松入门Python数据分析包pandas(二十五):循环序列分组
此系列文章收录在公众号中:数据大宇宙 数据处理 E pd 经常听别人说 Python 在数据领域有多厉害,结果学了很长时间,连数据处理都麻烦得要死。后来才发现,原来不是 Python 数据处理厉害,而是他有数据分析神器—— pandas 前言 这次是一位小伙伴提出的实际问题,刚好使用 pandas
此系列文章收录在公众号中:数据大宇宙 > 数据处理 >E-pd
经常听别人说 Python 在数据领域有多厉害,结果学了很长时间,连数据处理都麻烦得要死。后来才发现,原来不是 Python 数据处理厉害,而是他有数据分析神器—— pandas
前言
这次是一位小伙伴提出的实际问题,刚好使用 pandas 的解决思路上与 Excel 一致,因此写到这个系列中。
问题
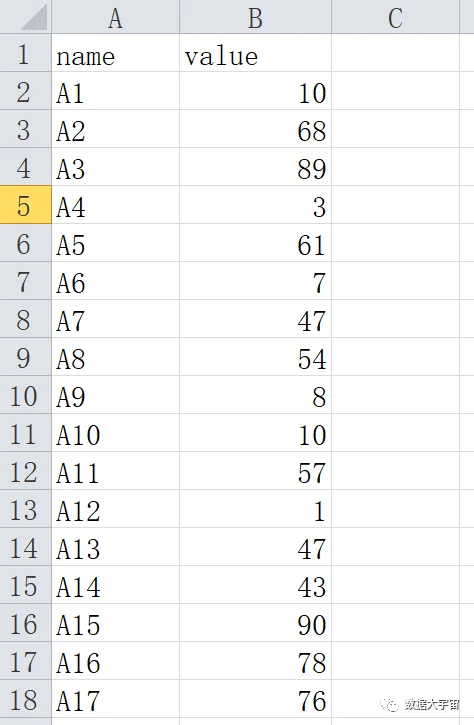
现有一份成绩表:
-
要求把以上各学生分成10个组,让每组的平均分尽可能接近
-
汇总输出各个组的信息(有什么人,平均分多少)
-
输出分组的组间差异信息(就简单标准差即可)
这不是 IQ 题,这里直接给出一种比较直观的解决思路(不一定最优):
-
按分数,把数据做一次升序排序
-
生成一新列,值为从 0-9(共10个数字) 的循环数列
-
按循环数列分组,即可得到结果
Excel 的做法
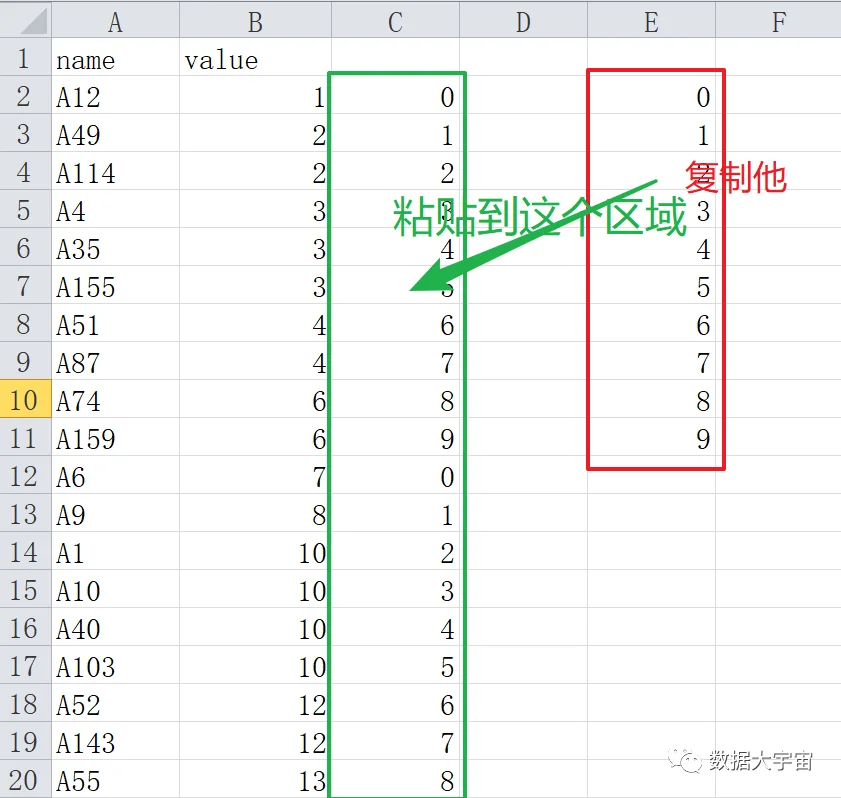
按照惯例,先看看如果在 Excel 上是怎么得到结果(流程前2步):
-
排序使用 Excel 内置功能,不详细讲解
-
输出循环数列,可以用函数公式,但这里当然用 Excel 的内置功能即可,先得到一列0-9(先输入0、1,再下拉即可),然后把这0-9的列复制粘贴到C列中即可
-
后面的分组,统计得到结果,就不要麻烦 Excel 了,你也会烦死
pandas 中的对应实现
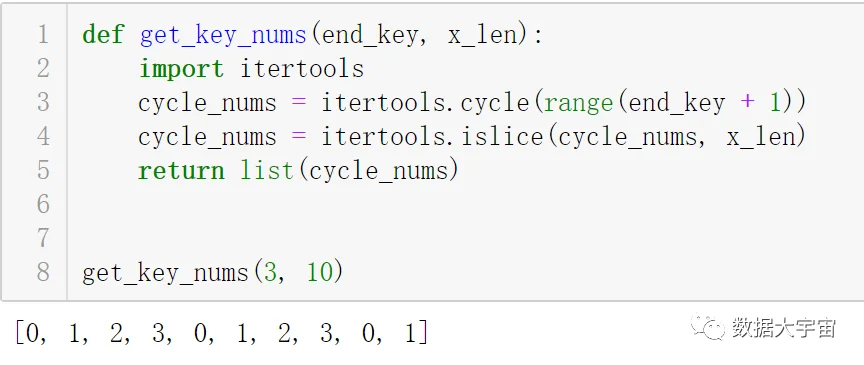
怎么样生成需求中的循环数列呢?pandas 上的确没有此操作,因为这实在太简单,本来 Python 就可以内置的库可以完成:
-
行1-5:自定义函数,用于生产循环数列
-
参数 end_key 指定数列的结束值,x_len 指定最终结果的数列长度
-
行2:需要使用 itertools 库,这里导入此库
-
行3:itertools.cycle 用于循环获取数据,我们给他一个数字序列(使用 range 生成),cycle 方法会不断从里面循环获取出元素
-
注意:千万不要直接把 cycle 方法转为实际序列,否则会产生死循环
-
行4:对刚刚得到的循环数列做切片
-
行5:转换成 list
-
行8:调用这个自定义函数看看效果
接下来是利用这个自定义函数生成分组依据的列,进行分组统计,得到结果:
-
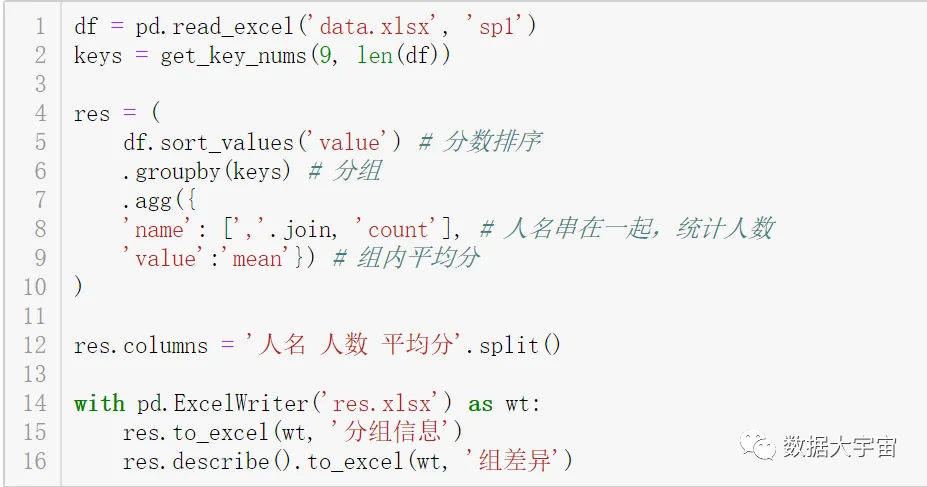
行1:加载数据
-
行2:调用之前定义的函数,获取分组依据
-
行4-10:按分数排序 + 分组统计结果
-
行8:对每个组中的人名(name) 串在一起(‘,’.join) ,同时求个数(count)
-
行12:修改表头
-
行15:把分组结果输出到工作表“分组信息”
-
行16:对分组结果输出一个统计信息到工作表“组差异”
排序、分组、汇总、统计到输出,就是这么简单直观。
pandas 在数据处理中的快速、便捷,体现得一览无遗!
更多 pandas 高级技巧,关注我的 pandas 专栏!
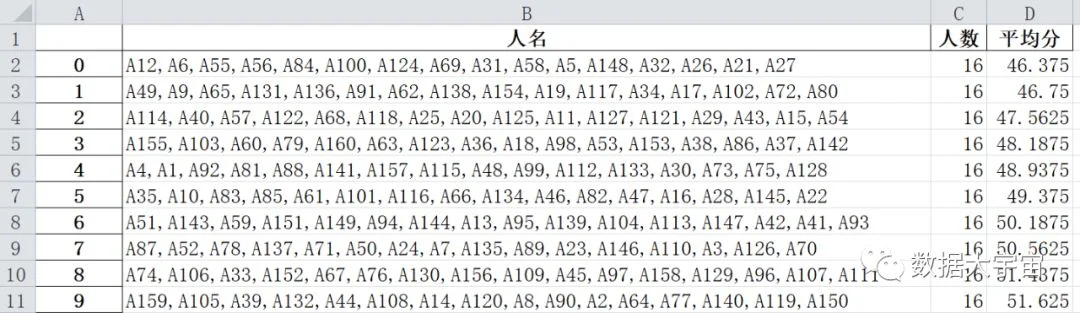
现在可以来看看生成的结果 Excel 文件:
-
这是“分组结果”
-
因为总人数为160,可以看到每组都是16人了
-
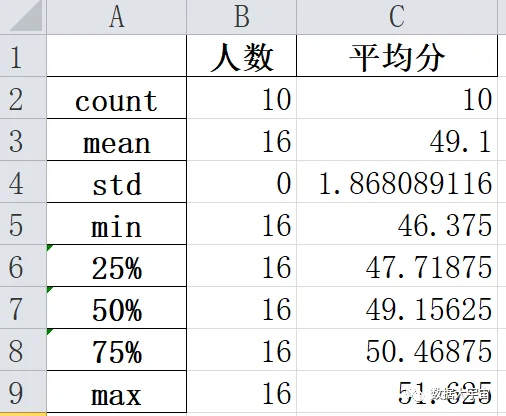
这是“组差异”
-
行3:平均每个组的分数为49.1
-
行4:每个组平均分平均差距只是1.86分,结果还可以接受
总结
本文重点:
- itertools 库中有许多相当实用的功能,值得学习
需要源码的小伙伴,公众号发送“数据处理”
觉得写得不错,点击右下方“在看”
如果希望从零开始学习 pandas ,那么可以看看我的 pandas 专栏。
扫描二维码
获取更多精彩
数据大宇宙